- 梦逐绝18小时前
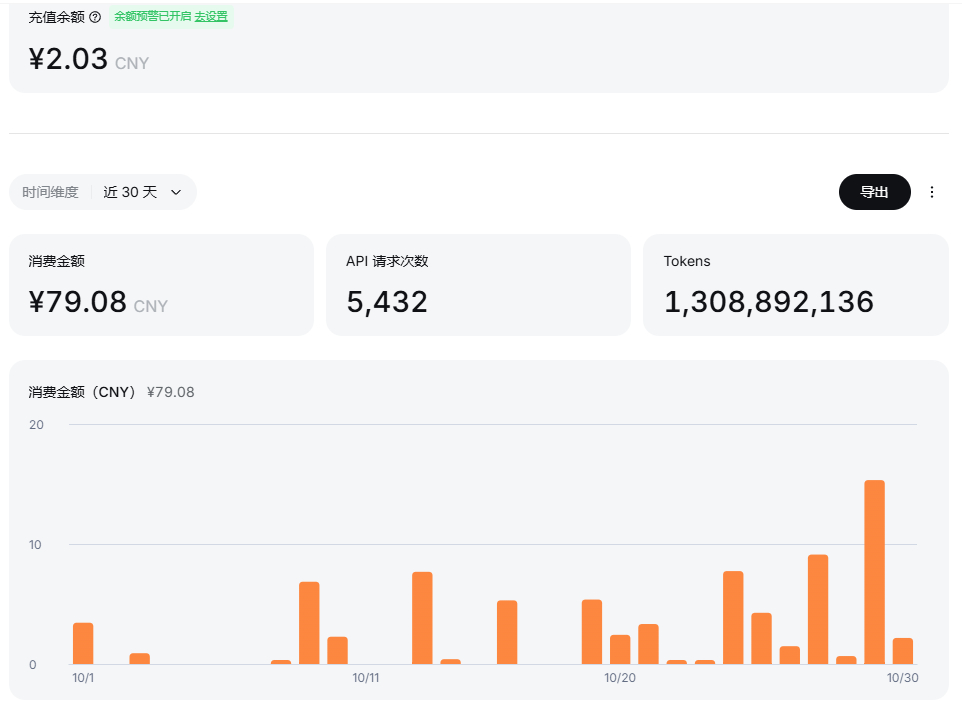
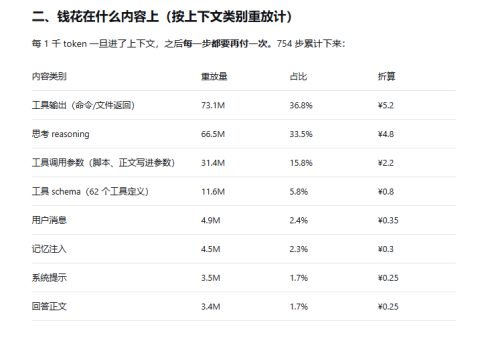
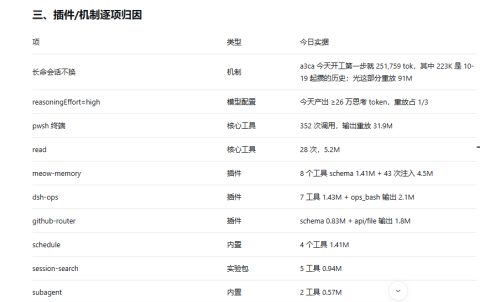
昨天在峰时让大肥鱼整了整插件,找、装、改、升级插件等等,然后后面我一看今天花了十几块,让她查了下原因说是会话太长了没有切换,我就想起之前经常刷到的压缩上下文的插件,我就想让她找个这种插件,她又告诉我dsh自带,现在设置的是70w上下文压缩,他建议我改成25w压缩,改完后我就问她会影响缓存命中吗,她说会影响,然后我就迷茫了,我到底是压不压缩,你们是怎么用的,需不需要改压缩设置,安装压缩上下文的插件,安装的话哪个插件效果好,会话多少需要切换新会话,救救孩子
 主楼
- 梦逐绝13小时前
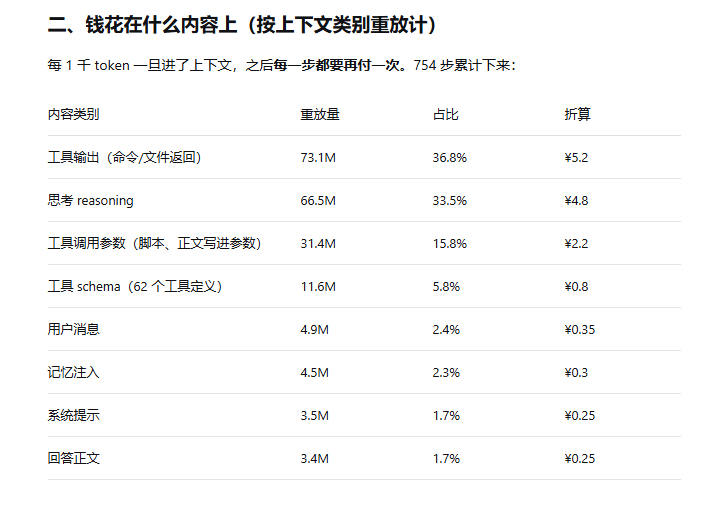
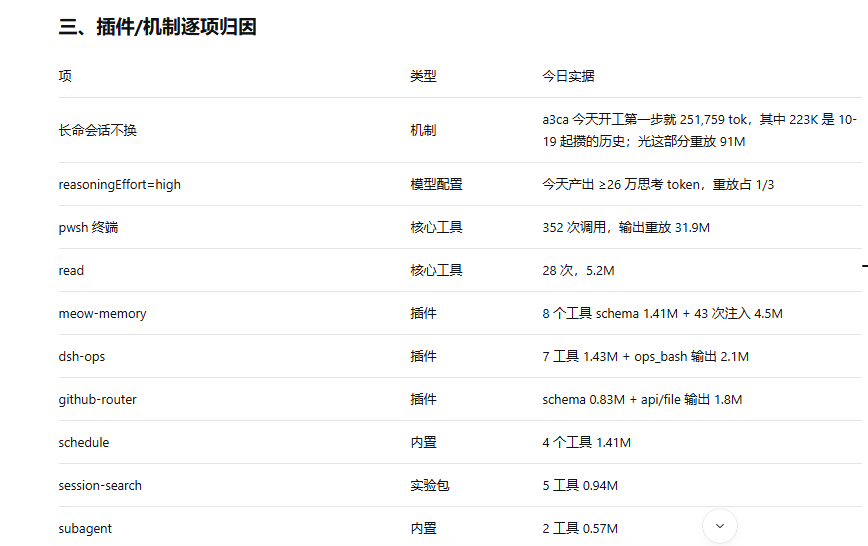
还有就是有没有那种将token花费列的非常详细的插件,我想看看是不是我装的插件增加了很多花费,感觉之前花费没有这么高啊
- 枫丿色8小时前
我平常用的就是billion context 加 ptc模式只要压缩一定影响缓存命中 这个压缩挺激进的 始终把上下文控制在100k-200k 模型记忆力会有一定下降 长任务下用这个还行 比官方的压缩好用些 确实能省钱 但是远没有总量下降看起来省 压缩是一定要的flash模型上下文过500k感觉就幻觉比较多了
- 噗噗好困3小时前
大肥鱼原生窗口是1M,你把压缩线设到600K左右,然后做个提示工具470K就提醒换会话就在优势注意力区间,相对来说会好点。
至于上下文衔接和历史记忆就得记忆类项目出手了。
现在的技术别指望根治,但至少能留能搜