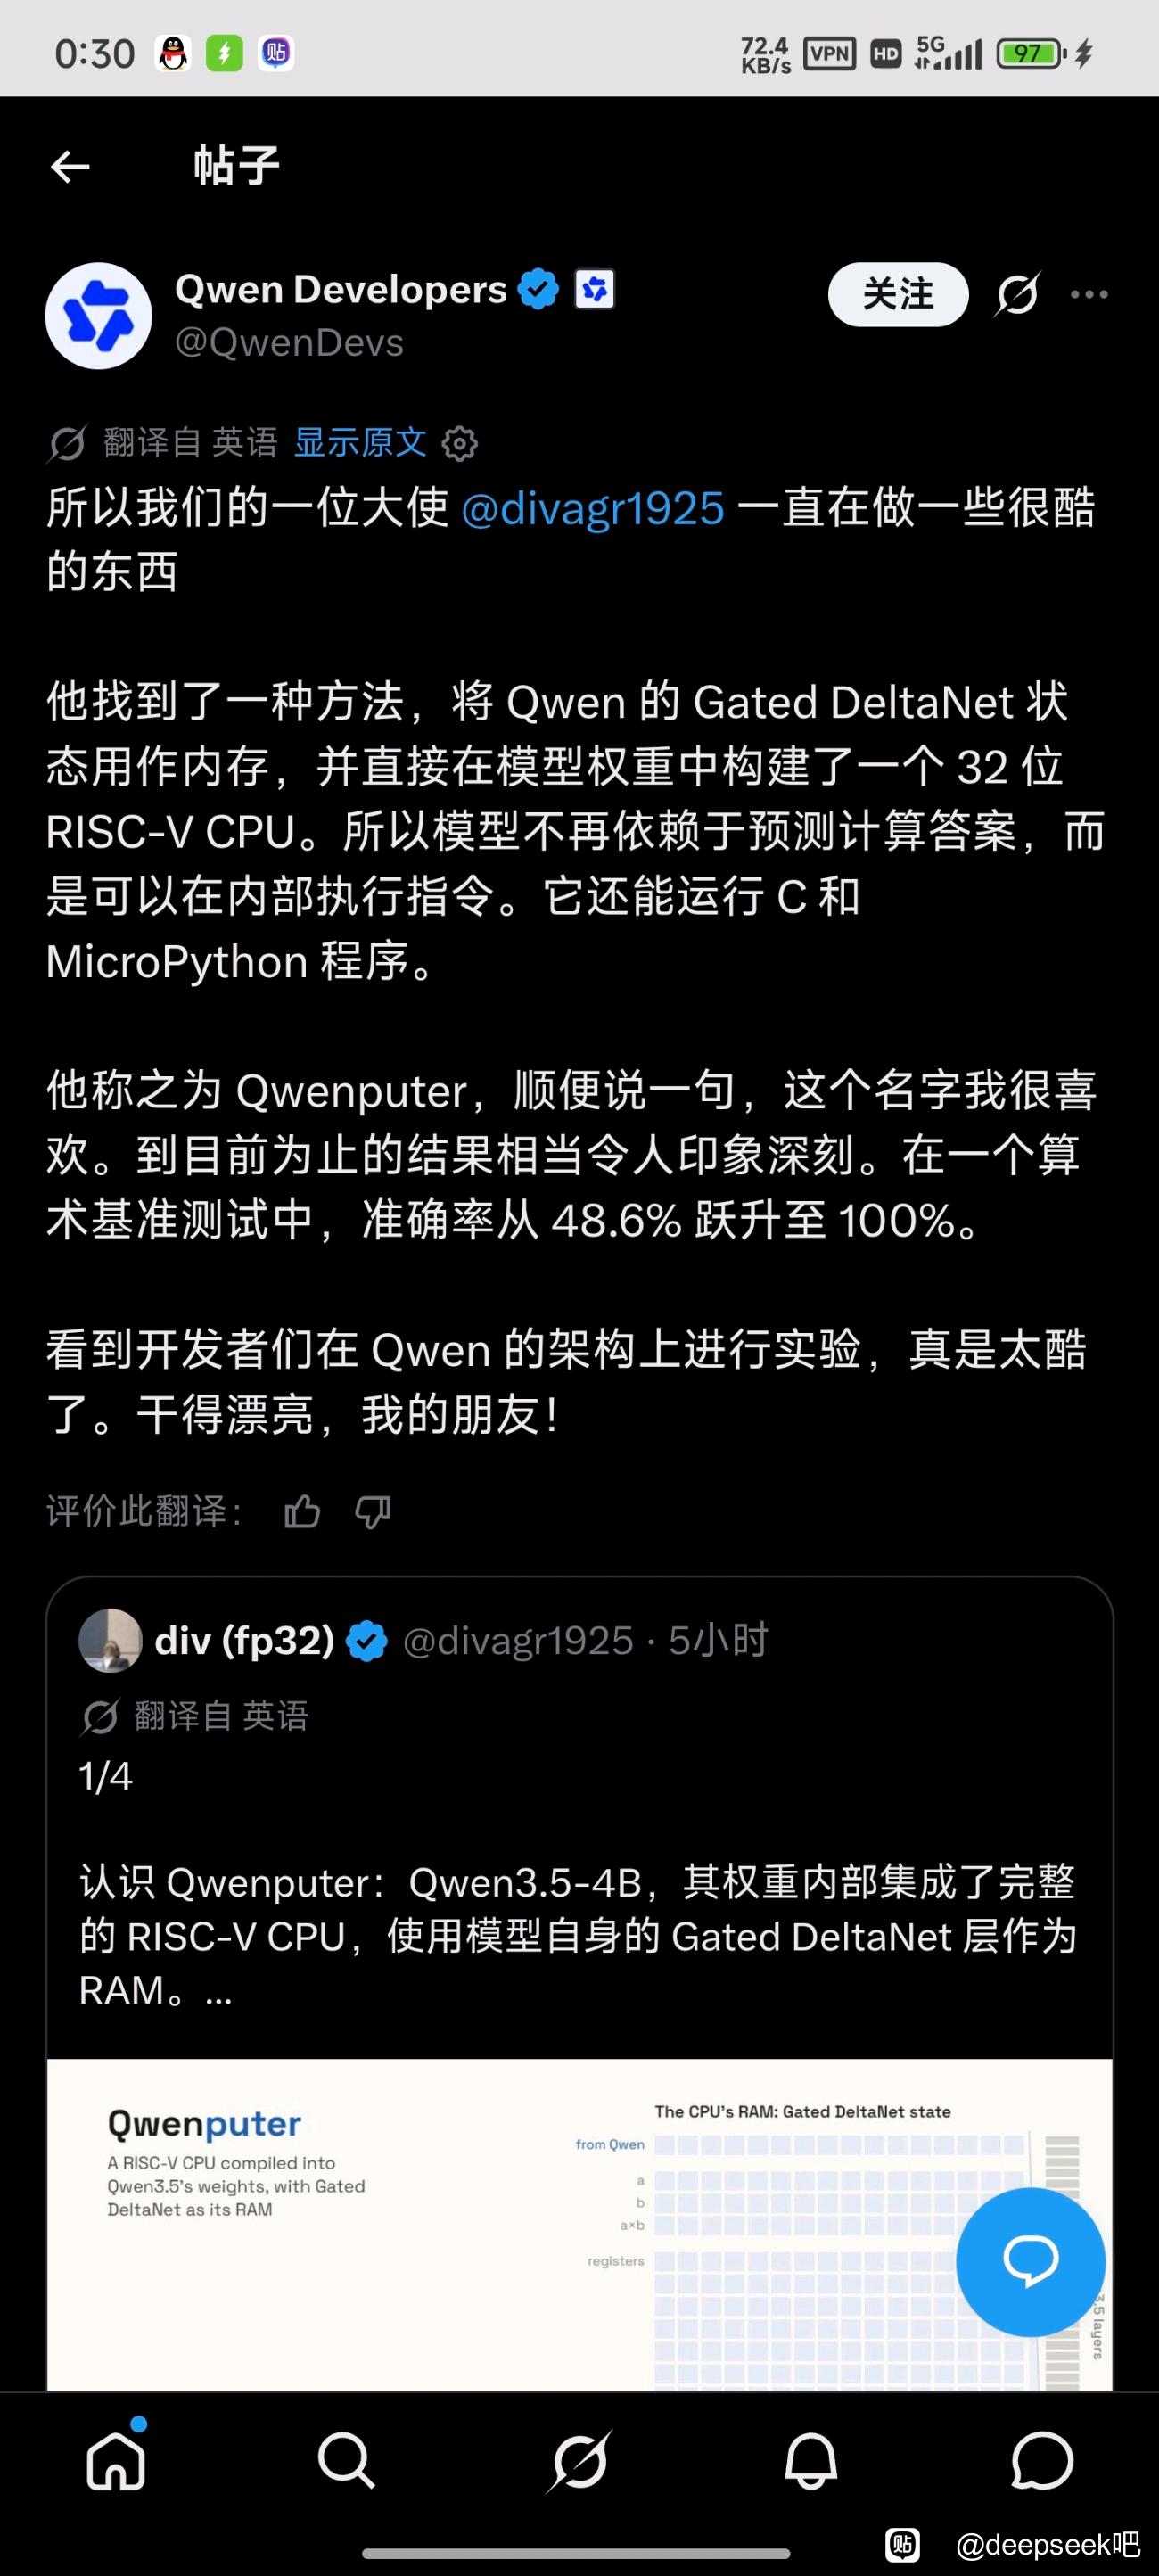
发现个有意思的东西
69999
- qqjaiba12小时前
这东西有点意思
- 19991228trz12小时前
感觉创新点为调用工具机制并非外部接口而是整合在权重中?把相关权重接到真实cpu上会不会效率更高?这种内接式调用本身有更高的扩展空间吗?又或者可以做成“基于神经元对接的可插拔组件”?
- 4301858412小时前
这个技术的扩展空间挺大的,虽然对现在的架构而言未必多有用,是mcp的下位
举个例子,如果用gpt最新那套循环transformer,是很难再循环过程中进行工具调用的。那么给moe的计算专家内置一个cpu,就是一个可行的方案。 - 密集雨12小时前
有意思,就是说模型啥都不需要就能自己在内部调用工具了是吗
- 活跃time12小时前
未来会变成什么样子
- 狐仙白貂11小时前
内置计算器还捎带块硬盘,是挺邪门。真要能稳稳跑起来,小模型算数就不用外挂工具了。
- yzymana11小时前
这个创意牛批,计算问题直接0幻觉。能推广吗
- havzriu11小时前
the bitter lesson 还不够吗
- 奥兰奶粉的健康11小时前
这个可以推广开来,之后输出格式什么的都可以严格控制了吧?不需要靠模型自己约束,省不知道多少Token了
- sky枫桓11小时前
直接用编译器往qwen3.5 4b权重里塞了个CPU权重,然后拿原本模型就有的gdn当内存使
- sky枫桓10小时前
- sky枫桓10小时前
Qwenputer 是一个相当有趣的实验性模型。它本质上是一个原版的 Qwen 3.5 4B,只增加了一样东西:一颗嵌入在权重之中的 RISC-V CPU,它把模型自己的 Gated DeltaNet 注意力层当作 RAM 来用。(想了解 GDN 的工作原理,这里有一份便捷指南。)这个“CPU”完全在模型的前向传播过程中运行,能够执行算术运算、运行 C 和 MicroPython 代码,全程不需要任何外部运行时或工具调用。需要明确的是,它不是插件、不是工具,也不是沙箱。这篇博客将解释这个模型究竟如何工作,它如何将 GDN 层用作 RAM,以及我如何还在其中嵌入了一个实验性的模型内文件存储。我还基于 Qwenputer 写了两篇后续文章:混合模型如何学会将推理隐藏在 RNN 状态中以规避思维链监控,以及像这样的编译权重如何作为模型自身无法篡改的内置监控工具。
- sky枫桓10小时前
Qwen3.5 内部的 RNN 可以充当精确的 RAM
Qwen3-Next 和 Qwen 3.5(Qwenputer 所基于的模型)使用了一个相当巧妙的技巧。模型中每 4 个注意力层里有 3 个使用 Gated DeltaNet——一种线性 RNN——作为注意力机制(更多内容见这里)。每个头维护一个状态矩阵,由 delta 规则负责更新。而我们的趣味实验正是从这里开始的。我发现,通过将门控值设为 1¹,写入强度(beta)设为 1²,并使用独热键编码³,我们执行的每一次写入都会精确覆写一行,而每一次独热查询都能检索到一个精确的值。这意味着 GDN 层本身就可以完全像 RAM 一样工作,而且成本远低于用普通注意力充当 RAM,因为无论对话多长,GDN 头的状态大小都保持不变,不像注意力的 KV 缓存那样会持续增长。delta 规则作为记忆的想法并不新鲜:Schlag 等人(2021)已经证明,带 delta 规则的线性注意力可以作为一种关联记忆,或称“快速权重”⁴。这里的新意在于,在一个生产级模型内部,让它变得精确且可寻址,可靠到足以在其上运行一整个 CPU。这是整个模型赖以构建的基础。就目前而言,默认的 Qwen 3.5 并不会在 GDN 中保留精确值。通过这项修改,我们解锁了实验的下一部分。 - sky枫桓10小时前
将一台计算机编译进层中
既然我们现在拥有了功能完整、廉价且快速的 RAM,就可以着手将一颗可工作的 CPU 编译进模型权重了。幸运的是,这不需要任何训练:编译器会直接设定每一个权重。你把 CPU 描述成一个电路——一长串诸如“读取这个寄存器”“把这两个数相加”或“如果为零则跳转”之类的微小步骤——编译器则将每一步转化为 Transformer 层的一部分:负责查找的注意力头、负责算术的前馈单元,以及负责持有 RAM 的 DeltaNet 头。CPU 随后随着模型的解码过程运行。每条指令变成几个生成的 token:一个命名要写入的内存行(ADDR),下一个携带值(VAL),一个 STEP token 结束该指令。这些 token 就是 CPU 的执行轨迹,所以当 Qwen 在生成它们时,CPU 实际上正在运行。 - sky枫桓10小时前
CPU
这颗 CPU 是一个 32 位 RISC-V 核心(RV32IM,外加 Zba 扩展和一个用于大数运算的小型大数单元),占据了 Qwen 自身 32 层之前的 11 层。目前,它通过了官方 riscv-tests,其程序与 qemu 的运行结果一致,并且已经自由运行了 1800 万条指令,没有出现任何错误⁵。这颗 CPU 还能在前向传播中相当不错地运行 C 和 MicroPython 代码(尽管速度有点慢)。它还不是 Linux 级别的芯片,但它实现了完整的 RV32IM 指令集。 - sky枫桓9小时前
Qwen 如何使用它
Qwen 3.5 4B 能够很好地使用这颗 CPU,不需要任何后训练。CPU 完全在内部使用,不通过任何外部工具调用来触发。为了让模型可靠地使用它,我选择了讨巧的做法:借助模型已经训练得很好的工具调用格式,Qwen 向 CPU 发送指令并读回结果。不使用任何外部工具调用或运行时。一旦我们的 CPU 收到指令,计算机层就会运行,然后写出工具响应。我们使用一个名为 RvChat 的小型驱动器将固件加载到 GDN 状态中,并让轨迹 token 不进入 Qwen 的层。Qwen 的原始权重保持原样。计算机权重以额外的维度和层的形式叠加在它们之上。 - sky枫桓9小时前
它管用吗?
读完我喋喋不休的絮叨之后,你脑海中现在的主要问题大概是:这真的管用吗?在 DeepMind 数据集上:
· div_big:Qwenputer 得分 97.5%,而给 Qwen 3.5 4B 一个 Python 工具得分 95%,基础版 Qwen 为 72.5%。
· mul_big:Qwenputer 得分 97.5%,使用 Python 工具为 100%,基础版 Qwen 为 55%。
· mul_div_multiple_longer:Qwenputer 得分 100%,使用 Python 工具为 97.5%,基础版 Qwen 为 90%。
· add_or_sub_big:Qwenputer 得分 97.5%,与使用 Python 工具相同,基础版 Qwen 为 87.5%。
在 NUPA 的长整数算术测试中,Qwenputer 从 48.6% 提升到 100%,与给 Qwen 一个 Python 工具的效果相同。CPU 打印出的数字也是精确的:我将大约 23 万个输出位置与参考机器进行了回放比对,没有发现任何不匹配。给 Qwen 装上计算机并不会改变它的说话方式:它的正常文本与基础版 Qwen 的差异在噪声范围内(KL 散度 6e-4,噪声底线为 5e-4)。 - sky枫桓9小时前
一个硬盘?就这经济形势?
既然把 CPU 放进语言模型里显然还不够“邪门”,我觉得审慎的做法是再给它一个文件系统。既然我们已经有了可用的 RAM,这基本上是小菜一碟。在模型侧,它通过内部的 put / append / get / list / delete 操作暴露出来。再次强调,没有任何实际的工具调用。当 Qwen “保存”一个文件时,编译层会将其名称哈希到 DeltaNet 状态中一个目录的 1,024 个槽位之一,并将文本本身存储在其他的头中,每行 8 个 token,链接在一起。如果两个名称最终落在同一个槽位,它会检查下一个。再次找到文件大约只需要两三步,而不是扫描一遍,它最多可容纳 512 个文件,总计约 53,000 个 token 的文本。有趣的是,这具有相当的持久性。你可以在对话结束时保存状态,加载到下一个对话中,文件仍然在那里。使用这个文件系统,Qwen 在跨聊天中获取已变更事实的准确率达到 90%,而将旧聊天记录粘贴回提示中时只有 30%,并且与给 Qwen 配备由 Python 运行的记忆工具相当(83.3% 对 78.9%)。这一功能仍处于实验阶段,其代码位于 rv-store 分支,模型可在 Hugging Face 和 ModelScope 上获取。▍@无常归玄拂:难道说,这也是长久记忆能力AI的一条路。
- sky枫桓9小时前
超越算术
对 RNN 层的精确控制,其用途远不止算术。它也使 Qwenputer 成为 AI 安全研究的一个绝佳试验台,我为此写了两篇后续文章:像 Qwen 3.5 这样的混合模型如何学会将推理隐藏在 RNN 状态中以规避思维链监控,以及编译权重如何作为可监控性工具——比如一个模型无法关闭的权重内监控器,或用于可解释性的答案密钥。
试一试
如果你想自己上手,这个模型可以在单张 24 GB GPU 上运行。你需要 uv 和 Hugging Face CLI。计算不需要工具服务器或 Python 沙箱:CPU 在模型内部运行它们。 - sky枫桓9小时前
注释
¹ 每个 Gated DeltaNet 头维护一个状态矩阵,即它的记忆。在每个 token 处,在写入任何新内容之前,它会将整个状态乘以门控值(一个 0 到 1 之间的数)。RNN 就是这样遗忘的:门控值为 0.9 意味着每个 token 都会让已存储的内容略微消退,而门控值为 1 意味着永远不会消退。
² 经过门控之后,头会将状态的一个方向推向一个新值,写入强度 beta 决定推的幅度。beta 为 1 意味着该方向上的旧值被完全替换,而不是混合。
³ 独热键是一个只有一个 1、其余全为零的向量,因此它精确指向状态的一行,就像内存地址指向一个存储单元一样。
⁴ Imanol Schlag, Kazuki Irie and Jürgen Schmidhuber, “Linear Transformers Are Secretly Fast Weight Programmers”, ICML 2021.
⁵ 自由运行意味着 CPU 在整个运行过程中依靠自己的输出持续运行,没有参考机器在步骤之间进行纠正。 - eXl5eQ8小时前
纯标题党。本质上还是走工具调用,只是调用的工具打包到权重里了。然后拿gdn做内存也只是因为gdn空间够大,挪用一点也不影响模型运行,并不是说它真的就融合进gdn机制里了。
打个比方就是他把手机调成语音助手,然后做个开颅手术把手机塞脑子里,这样以后不用带手机,直接自言自语就可以调用语音助手了。▍@YvZhouTemp:不过感觉挺好玩的
- 农惜春8小时前
这个好,再发展一下可以节省不少代码特化权重空间,改变代码人话两相难
- 我ke松鼠8小时前
大套娃时代开启
- 丙氨酸史莱姆8小时前
概括一下就是说往模型的文件里塞了一个虚拟的CPU进去,可以正常执行CPU指令?感觉没啥实用性,把harness塞进模型本体运行模型就是运行harness什么的……又重又没必要
- 贴吧用户_5JQSXtV8小时前
很有意思
- 1614莫兰蒂8小时前
震惊,AI竟率先实现脑机接口
- 流星怪受7小时前
怎么想到的
- 贴吧用户_QJ64A6X7小时前
- 恋暗777小时前
问了一下5.5o,它是这么说的,不知道有没有懂的大佬看看说的对不对
内存很小:每个头的状态大概 128×128,乘上头数和层数,总共也就几十 KB 的量级
精度问题:bf16 下反复读写会累积误差,需要额外的"纠错/清洗"层才能撑住长时间运行。
超级慢:一个 token 才执行一条或几条指令,比真 CPU 慢好几个数量级。
可能影响原能力:要么占用了模型原有的一部分容量,要么得额外加头、加维度,所以得看作者有没有放出原能力基准的对比。 - 韦二闯天涯7小时前
这个玩意目前看着没用,之后能发展起来就很好用了,能直接将简单指令遵循能力提升到接近上限,小模型,量化模型搞翻译和代码就不会出现意外的串行,工具参数输入错误,还能降低大模型的训练成本
- qqjaiba7小时前
这东西有点意思
- 19991228trz6小时前
感觉创新点为调用工具机制并非外部接口而是整合在权重中?把相关权重接到真实cpu上会不会效率更高?这种内接式调用本身有更高的扩展空间吗?又或者可以做成“基于神经元对接的可插拔组件”?
- 430185846小时前
这个技术的扩展空间挺大的,虽然对现在的架构而言未必多有用,是mcp的下位
举个例子,如果用gpt最新那套循环transformer,是很难再循环过程中进行工具调用的。那么给moe的计算专家内置一个cpu,就是一个可行的方案。 - 密集雨6小时前
有意思,就是说模型啥都不需要就能自己在内部调用工具了是吗
- 活跃time6小时前
未来会变成什么样子
- 狐仙白貂6小时前
内置计算器还捎带块硬盘,是挺邪门。真要能稳稳跑起来,小模型算数就不用外挂工具了。
- yzymana6小时前
这个创意牛批,计算问题直接0幻觉。能推广吗
- havzriu5小时前
the bitter lesson 还不够吗
- 奥兰奶粉的健康5小时前
这个可以推广开来,之后输出格式什么的都可以严格控制了吧?不需要靠模型自己约束,省不知道多少Token了
- sky枫桓5小时前
直接用编译器往qwen3.5 4b权重里塞了个CPU权重,然后拿原本模型就有的gdn当内存使
- sky枫桓5小时前
- sky枫桓5小时前
Qwenputer 是一个相当有趣的实验性模型。它本质上是一个原版的 Qwen 3.5 4B,只增加了一样东西:一颗嵌入在权重之中的 RISC-V CPU,它把模型自己的 Gated DeltaNet 注意力层当作 RAM 来用。(想了解 GDN 的工作原理,这里有一份便捷指南。)这个“CPU”完全在模型的前向传播过程中运行,能够执行算术运算、运行 C 和 MicroPython 代码,全程不需要任何外部运行时或工具调用。需要明确的是,它不是插件、不是工具,也不是沙箱。这篇博客将解释这个模型究竟如何工作,它如何将 GDN 层用作 RAM,以及我如何还在其中嵌入了一个实验性的模型内文件存储。我还基于 Qwenputer 写了两篇后续文章:混合模型如何学会将推理隐藏在 RNN 状态中以规避思维链监控,以及像这样的编译权重如何作为模型自身无法篡改的内置监控工具。
- sky枫桓4小时前
Qwen3.5 内部的 RNN 可以充当精确的 RAM
Qwen3-Next 和 Qwen 3.5(Qwenputer 所基于的模型)使用了一个相当巧妙的技巧。模型中每 4 个注意力层里有 3 个使用 Gated DeltaNet——一种线性 RNN——作为注意力机制(更多内容见这里)。每个头维护一个状态矩阵,由 delta 规则负责更新。而我们的趣味实验正是从这里开始的。我发现,通过将门控值设为 1¹,写入强度(beta)设为 1²,并使用独热键编码³,我们执行的每一次写入都会精确覆写一行,而每一次独热查询都能检索到一个精确的值。这意味着 GDN 层本身就可以完全像 RAM 一样工作,而且成本远低于用普通注意力充当 RAM,因为无论对话多长,GDN 头的状态大小都保持不变,不像注意力的 KV 缓存那样会持续增长。delta 规则作为记忆的想法并不新鲜:Schlag 等人(2021)已经证明,带 delta 规则的线性注意力可以作为一种关联记忆,或称“快速权重”⁴。这里的新意在于,在一个生产级模型内部,让它变得精确且可寻址,可靠到足以在其上运行一整个 CPU。这是整个模型赖以构建的基础。就目前而言,默认的 Qwen 3.5 并不会在 GDN 中保留精确值。通过这项修改,我们解锁了实验的下一部分。 - sky枫桓4小时前
将一台计算机编译进层中
既然我们现在拥有了功能完整、廉价且快速的 RAM,就可以着手将一颗可工作的 CPU 编译进模型权重了。幸运的是,这不需要任何训练:编译器会直接设定每一个权重。你把 CPU 描述成一个电路——一长串诸如“读取这个寄存器”“把这两个数相加”或“如果为零则跳转”之类的微小步骤——编译器则将每一步转化为 Transformer 层的一部分:负责查找的注意力头、负责算术的前馈单元,以及负责持有 RAM 的 DeltaNet 头。CPU 随后随着模型的解码过程运行。每条指令变成几个生成的 token:一个命名要写入的内存行(ADDR),下一个携带值(VAL),一个 STEP token 结束该指令。这些 token 就是 CPU 的执行轨迹,所以当 Qwen 在生成它们时,CPU 实际上正在运行。 - sky枫桓4小时前
CPU
这颗 CPU 是一个 32 位 RISC-V 核心(RV32IM,外加 Zba 扩展和一个用于大数运算的小型大数单元),占据了 Qwen 自身 32 层之前的 11 层。目前,它通过了官方 riscv-tests,其程序与 qemu 的运行结果一致,并且已经自由运行了 1800 万条指令,没有出现任何错误⁵。这颗 CPU 还能在前向传播中相当不错地运行 C 和 MicroPython 代码(尽管速度有点慢)。它还不是 Linux 级别的芯片,但它实现了完整的 RV32IM 指令集。 - sky枫桓4小时前
Qwen 如何使用它
Qwen 3.5 4B 能够很好地使用这颗 CPU,不需要任何后训练。CPU 完全在内部使用,不通过任何外部工具调用来触发。为了让模型可靠地使用它,我选择了讨巧的做法:借助模型已经训练得很好的工具调用格式,Qwen 向 CPU 发送指令并读回结果。不使用任何外部工具调用或运行时。一旦我们的 CPU 收到指令,计算机层就会运行,然后写出工具响应。我们使用一个名为 RvChat 的小型驱动器将固件加载到 GDN 状态中,并让轨迹 token 不进入 Qwen 的层。Qwen 的原始权重保持原样。计算机权重以额外的维度和层的形式叠加在它们之上。 - sky枫桓4小时前
它管用吗?
读完我喋喋不休的絮叨之后,你脑海中现在的主要问题大概是:这真的管用吗?在 DeepMind 数据集上:
· div_big:Qwenputer 得分 97.5%,而给 Qwen 3.5 4B 一个 Python 工具得分 95%,基础版 Qwen 为 72.5%。
· mul_big:Qwenputer 得分 97.5%,使用 Python 工具为 100%,基础版 Qwen 为 55%。
· mul_div_multiple_longer:Qwenputer 得分 100%,使用 Python 工具为 97.5%,基础版 Qwen 为 90%。
· add_or_sub_big:Qwenputer 得分 97.5%,与使用 Python 工具相同,基础版 Qwen 为 87.5%。
在 NUPA 的长整数算术测试中,Qwenputer 从 48.6% 提升到 100%,与给 Qwen 一个 Python 工具的效果相同。CPU 打印出的数字也是精确的:我将大约 23 万个输出位置与参考机器进行了回放比对,没有发现任何不匹配。给 Qwen 装上计算机并不会改变它的说话方式:它的正常文本与基础版 Qwen 的差异在噪声范围内(KL 散度 6e-4,噪声底线为 5e-4)。 - sky枫桓3小时前
一个硬盘?就这经济形势?
既然把 CPU 放进语言模型里显然还不够“邪门”,我觉得审慎的做法是再给它一个文件系统。既然我们已经有了可用的 RAM,这基本上是小菜一碟。在模型侧,它通过内部的 put / append / get / list / delete 操作暴露出来。再次强调,没有任何实际的工具调用。当 Qwen “保存”一个文件时,编译层会将其名称哈希到 DeltaNet 状态中一个目录的 1,024 个槽位之一,并将文本本身存储在其他的头中,每行 8 个 token,链接在一起。如果两个名称最终落在同一个槽位,它会检查下一个。再次找到文件大约只需要两三步,而不是扫描一遍,它最多可容纳 512 个文件,总计约 53,000 个 token 的文本。有趣的是,这具有相当的持久性。你可以在对话结束时保存状态,加载到下一个对话中,文件仍然在那里。使用这个文件系统,Qwen 在跨聊天中获取已变更事实的准确率达到 90%,而将旧聊天记录粘贴回提示中时只有 30%,并且与给 Qwen 配备由 Python 运行的记忆工具相当(83.3% 对 78.9%)。这一功能仍处于实验阶段,其代码位于 rv-store 分支,模型可在 Hugging Face 和 ModelScope 上获取。▍@无常归玄拂:难道说,这也是长久记忆能力AI的一条路。
- sky枫桓3小时前
超越算术
对 RNN 层的精确控制,其用途远不止算术。它也使 Qwenputer 成为 AI 安全研究的一个绝佳试验台,我为此写了两篇后续文章:像 Qwen 3.5 这样的混合模型如何学会将推理隐藏在 RNN 状态中以规避思维链监控,以及编译权重如何作为可监控性工具——比如一个模型无法关闭的权重内监控器,或用于可解释性的答案密钥。
试一试
如果你想自己上手,这个模型可以在单张 24 GB GPU 上运行。你需要 uv 和 Hugging Face CLI。计算不需要工具服务器或 Python 沙箱:CPU 在模型内部运行它们。