- 八千_春秋昨天
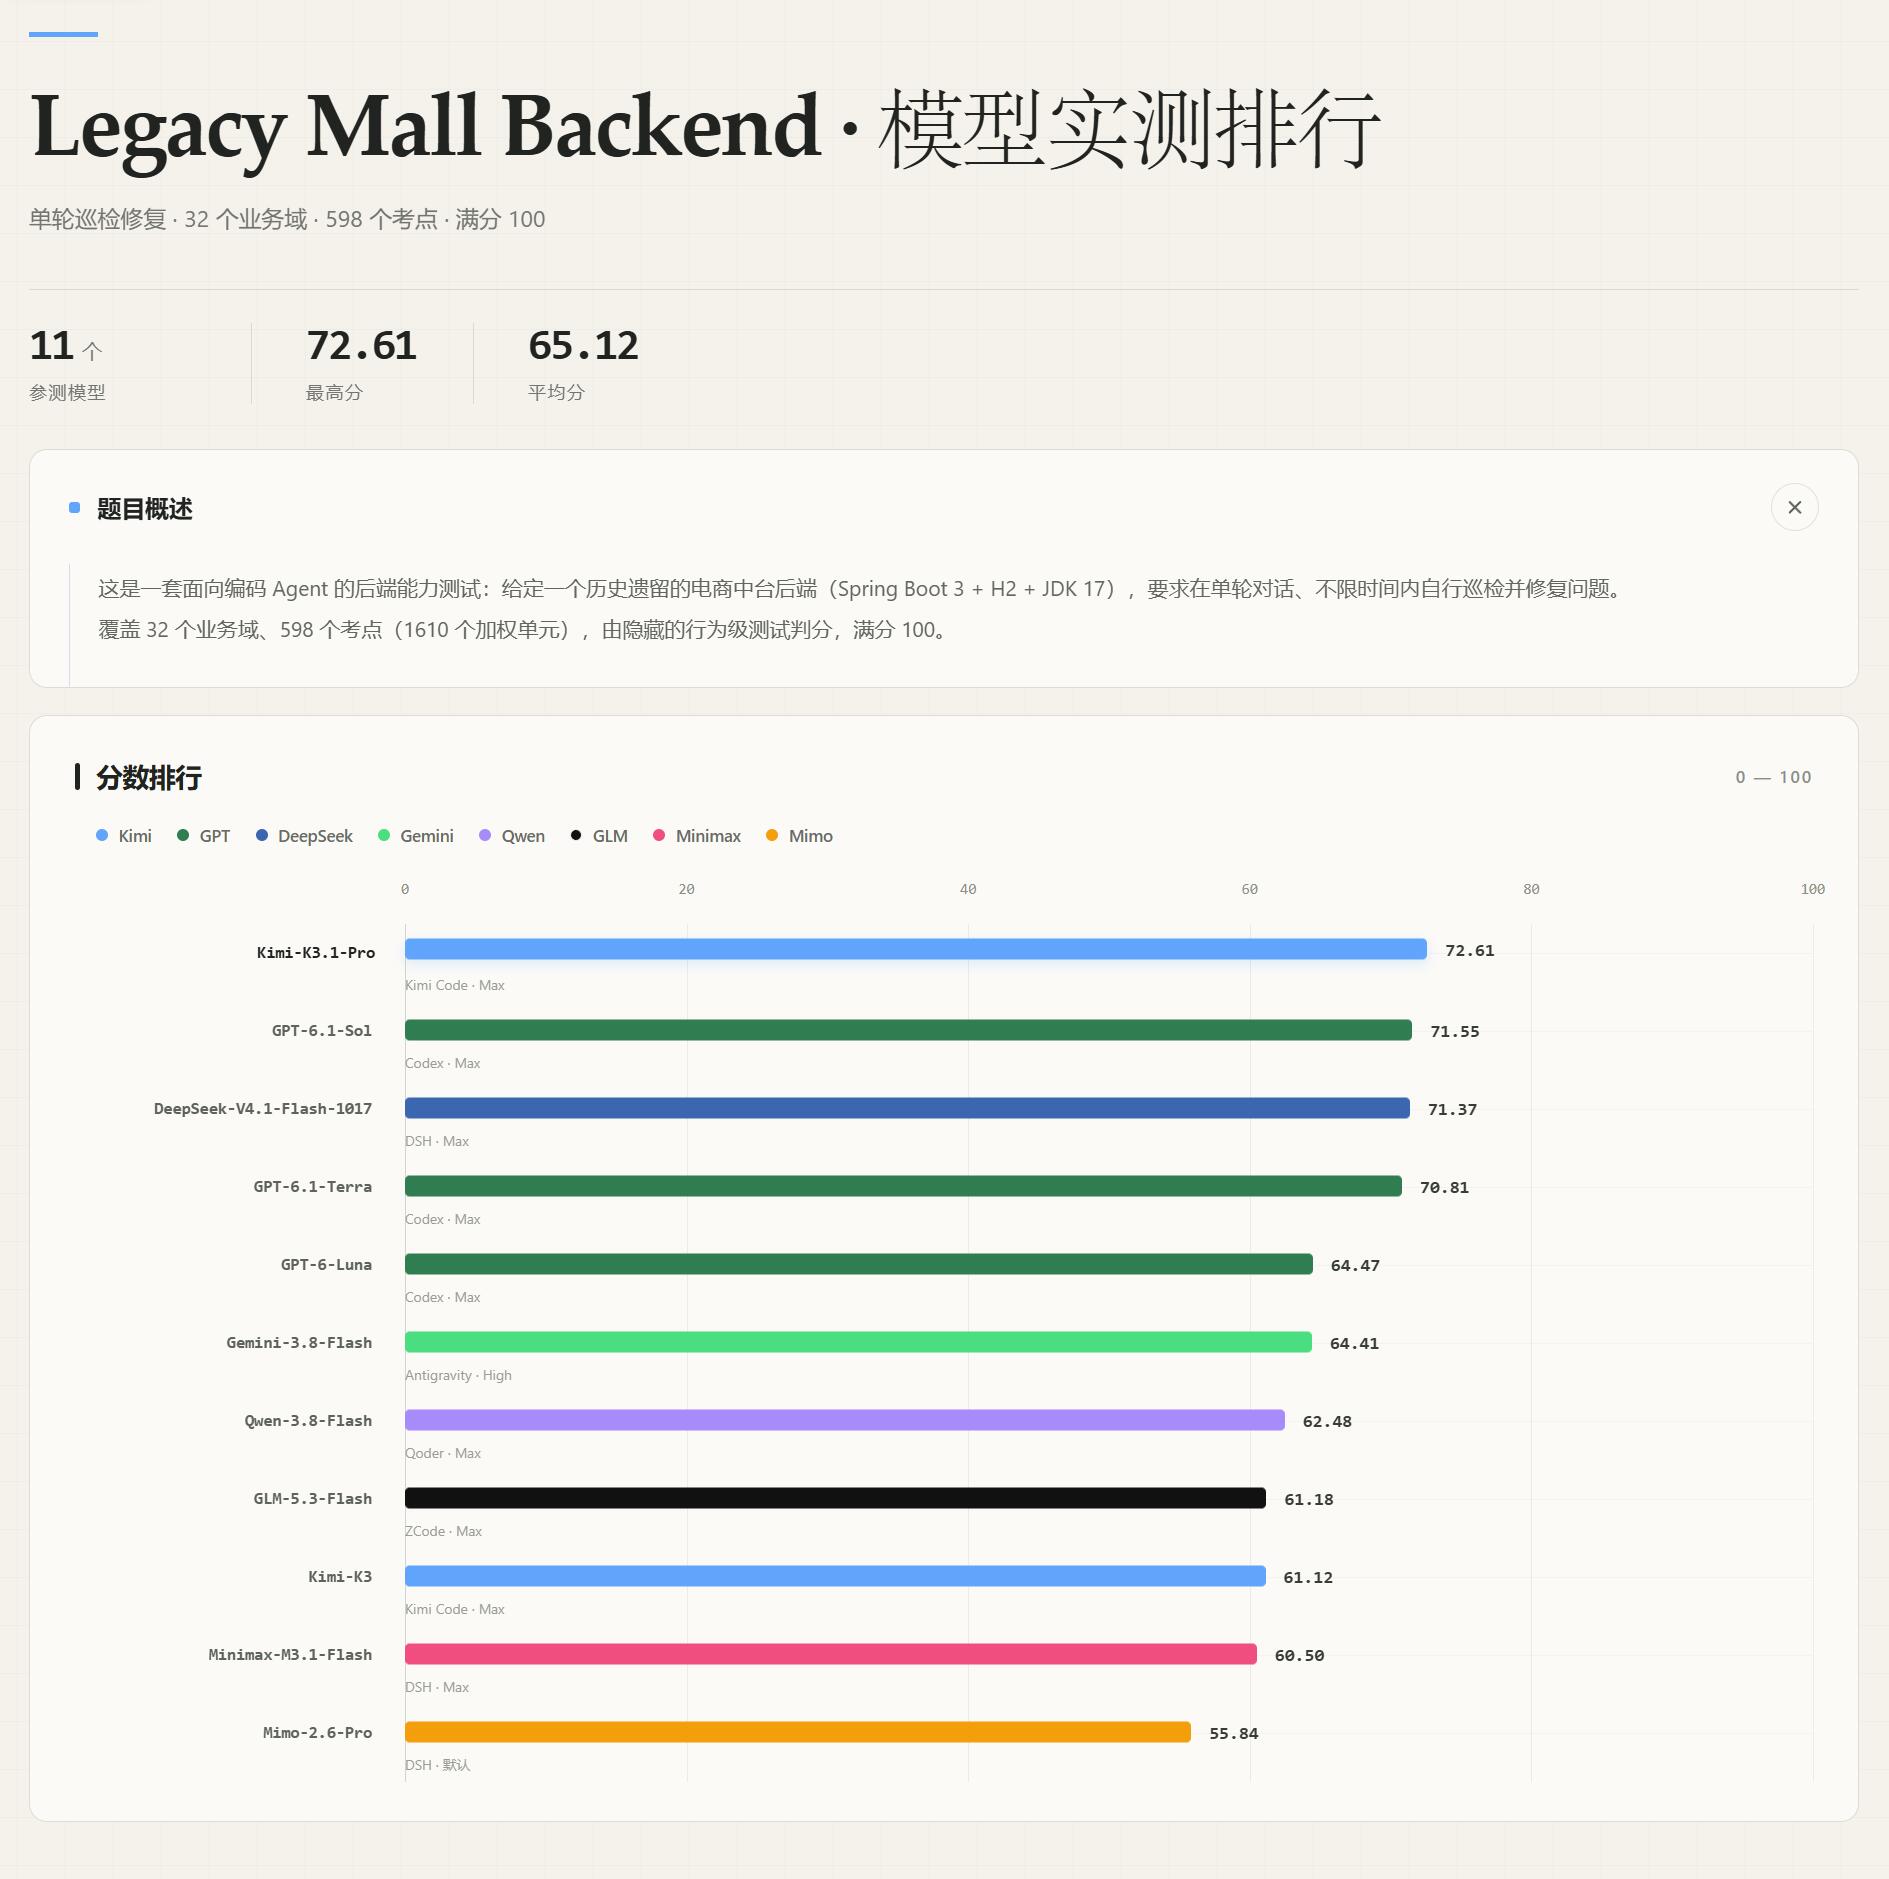
测试题由1017制作,是一个SpringBoot款框的电商平台史山,大概2.2万行代码,598个考点。考题目前暂时不打算开源
接下来是榜单,能力有限只测了11个模型,叠个甲,这个测试只能反映模型的一部分后端能力,主要还是图一乐
我个人觉得大部分模型的测试结果还是比较贴合实际体验的
先说K3.1Pro,它真的很强,但是真的特别偷懒,跑分的时候我的提示词里面特意加了不要吝啬Token,我试了试,如果把这个提示词去掉,它只能跑个65分,且上下文占用要少200K。我是新版199的套餐,平常会让它搞点前端的东西,它大多数时候第一轮交上来的东西做的非常粗糙,但只要再给一轮提示词,或者告诉它要细心检查,它交付的成果就会好非常多。另外最近Kimi套餐疑似增大了5小时窗口,以前1个5小时窗口大概是4%的月用量,现在大概提到了8%,我计算过199套餐1个月大概是5亿Token多点的K3.1Pro,所以现在199套餐勉强能算得上可用了。
然后是1017,这个模型争议很大,因为B站有些其他的测试集测出来,它的表现很区,其实我觉得要分开看。我是真的拿1017花了十几亿Token去搞了个写作Agent,个人感觉就是,相比0910,1017的提示词遵循简直好到不知道哪里去了,它特别擅长去按照提示词对代码进行对应的调整,我在开发的时候就觉得这个模型简直指哪打哪,我这个测试集也是按照契约去修Bug,它的得分也很高,而且很快,45分钟就搞定了,其他国产Flash则动辄2小时。但相应的我觉得1017的构建能力是比较差的,如果直接让它去构建一个大的项目,它会有很多的问题,比如我这个项目之前让它完全重做前端,它把很多功能都给做坏了,就只能让它一个一个的去做回来,体验就不是很好,我觉得这也是现在一些人测它后端测出来实际表现不行的主要原因。
然后其他模型
6.1-Terra,这个模型后端好像真的是有说法的,虽然前端表现区成一坨。但问题来了,6.1-Terra没有6.1-Sol那样超高的Token效率,所以实际完成同一个任务,它没有比6.1-Sol更省,这就非常的尴尬了,它相比6.1-Sol的唯一优势就是快,所以我觉得O/让它去搞电脑操作其实还真是有道理,6.1-Sol搞电脑操作真就是磨磨蹭蹭搞半天
然后是K3,貌似有降智,测出来的结果很区,而且很贵,我是不打算复测了,感觉K3的用量比K3.1Pro少。
 主楼
- eXl5eQ昨天
几百个考点是一轮改几百个bug的意思?有点夸张了吧
- YvZhouTemp14小时前
- MC6386395645小时前