 agents昨天
DeepSeek 在 10 月 17 日更新了 V4.1 Flash 1017,称它在复杂项目开发和 Agent 基准上的表现更好,任务运行时间与输出长度也有所缩短。官方展示的例子包括从零生成游戏和 3D 场景。官方更新说明让人很容易联想到一个问题:模型是不是已经能把复杂工作独立做完了?
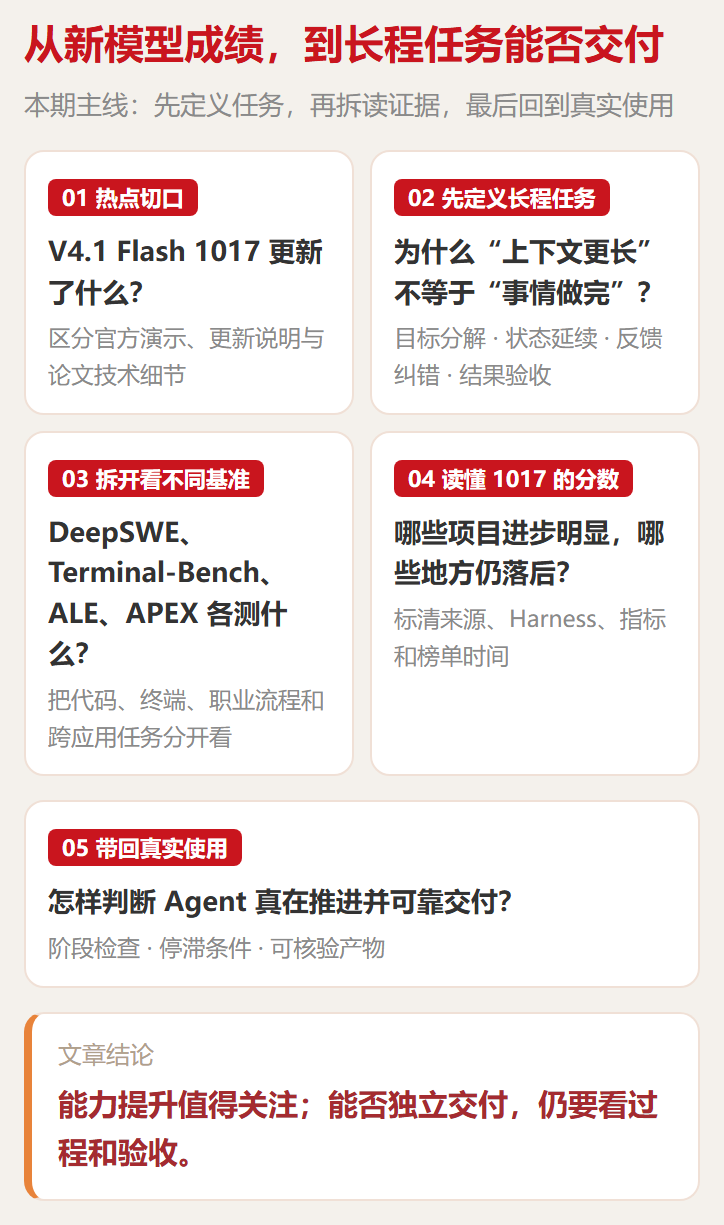
先别急着下结论。一个模型能连续输出很多轮,和一个 Agent 能把跨步骤的任务交付好,是两件事。要判断 1017 的进步意味着什么,得先拆开"长程任务"到底难在哪,再看不同基准分别测到了哪一段能力。
先把"长程任务"说清楚:不是把提示词写长
让模型总结一份很长的报告,主要考验它能否处理长上下文;让 Agent 把一个需求变成可运行的软件,则还要经历一连串相互依赖的工作:理解目标、拆分计划、修改文件、运行程序、读懂报错、调整方案,最后验证交付物。
这里说的"长程任务",重点不是花了多少分钟,也不是上下文窗口有多大,而是后续步骤依赖前面执行的结果,任务状态会不断变化,Agent 必须在多轮行动中维持目标、吸收反馈并修正计划。一步出错不一定致命;发现错误后仍重复原动作,或者做完了却没有验证,才会让整项工作失去可靠性。
可以把一项长任务想成一个循环,而不是一条只往前走的直线:
这也是为什么"模型能读一百万 token"不等于"Agent 能完成一百万 token 的工作"。长上下文解决的是材料能否放得下;任务完成还依赖计划、工具、状态管理、反馈和验收。
1017 更新了什么,哪些细节还没有公开
DeepSeek 的10 月 17 日更新说明把 V4.1 Flash 升级为 1017,并称新版本用"基于自反馈的强化学习"提升了从零开发完整项目的能力。官方发布页展示了网页游戏、Godot 游戏复刻和 3D 场景等案例。这些案例能说明模型在特定提示和工具环境下可以生成较完整的项目,但它们属于厂商展示,不能单独证明模型在不同任务、不同 Agent 框架下都能稳定交付。
这里需要分清两份资料。1017 的更新公告介绍了自反馈强化学习和项目生成示例,但没有公开这次更新的完整训练配方、奖励设计或消融实验。DeepSeek 在 9 月发布的 V4.1 Flash 技术报告,则详细介绍了 V4.1 Flash 的长上下文与 Agent 训练设计;它可以帮助理解这个模型家族的技术背景,但不能把报告中的每项设计都当成 1017 这次更新新增的内容。
报告里一个和长程任务直接相关的设计,是 Causal Encoder–Decoder(CED)架构。模型在处理输入材料时每个 token 激活约 8B 参数,在生成输出时激活约 16B;配合 CSA2 跨层复用、FP4 KV Cache 等技术,报告称它把全局 KV Cache 的占用压到上一代 V4 Flash 的约四分之一,持久化缓存约八分之一。模型支持最长 1M token 上下文。
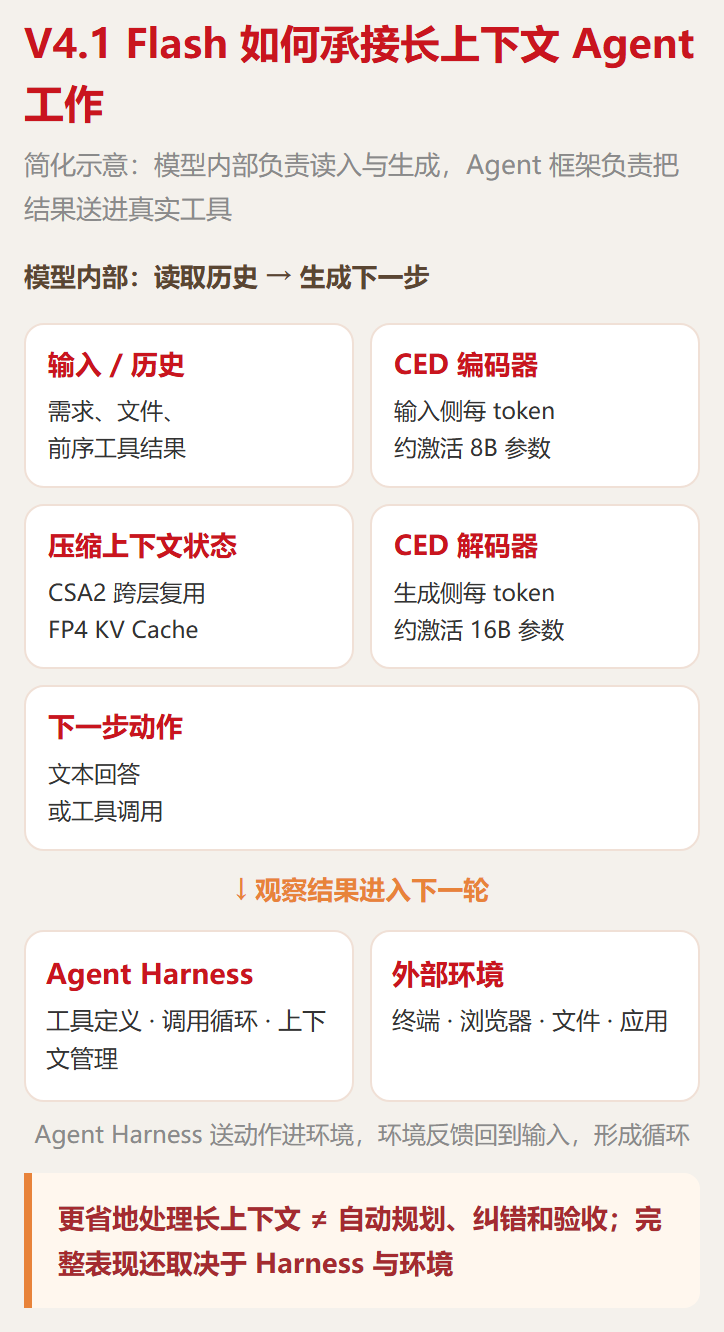
这些设计主要解决"长材料和长交互如何更经济地处理"。KV Cache 可以粗略理解为模型在逐步生成时保存的中间状态;长任务越多轮,历史状态越大,缓存读写的成本就越明显。压缩缓存和降低输入侧开销,能改善长上下文 Agent 的部署成本与速度,但它们本身不会替 Agent 判断哪个报错重要、该不该换计划,也不会替它验证最终结果。
技术报告还把训练重点放在数据管线、合成任务和多种 Agent 框架的交互轨迹上,并报告不同框架下的测试结果。这个思路很值得关注:Agent 不是只在对话框里回答,它要适应工具接口、提示词、上下文管理和轮次控制。模型在一个框架里的成绩,并不能自动代表换到另一个框架后仍然一样好。
榜单不是一场比赛:四类测试照出不同能力
DeepSeek 在1017 模型卡里列出了与若干主流模型的对照。下面只摘取和长程 Agent 最相关的四项。分数按模型卡原样列出;每个基准的任务、评分方式和测试设置不同,不能把四列分数当作同一把尺子,也不应把它们加总成一个"总冠军"。
基准主要在测什么V4.1 Flash 1017上一版GPT-5.6 SolOpus 5
DeepSWE v1.1在真实代码仓库中完成较长的软件工程任务77.074.273.074.0
Terminal-Bench 4.0在终端环境中完成多类实际任务42.331.239.951.8
Agents' Last Exam在专业工作环境中完成可核验的长流程任务35.431.826.728.6
Apex Bench v1.1跨文件和沟通材料处理专业工作任务72.164.654.365.8
从这组厂商公布的数据里,可以读出两件事。第一,1017 相比上一版在四项列出的任务上都有提升,尤其 Terminal-Bench 从 31.2 到 42.3,变化幅度值得关注。第二,它并没有在所有测试里领先:Terminal-Bench 上 Opus 5 的分数仍高于 1017。换句话说,模型进步可以很明显,能力也仍然有边界。
基准之间的差别,比名次更值得看。DeepSWE 面向代码仓库修复与工程变更,回答的是"能否在已有项目里把软件任务做出来";Terminal-Bench 把 Agent 放进沙盒终端,考察它能否处理复杂命令行工作;Agents' Last Exam 面向真实职业流程,任务分布在多个行业,并强调可验证结果;Apex Bench 则把信息放在不同文件和沟通记录里,测试 Agent 能否找到组织背景、据此完成专业产物。
因此,DeepSWE 上的高分不能直接推出它一定擅长操作办公软件;终端里的任务成功,也不等于它能稳定处理含糊的跨应用工作。对读者来说,先问"我的任务更像哪一种基准",比问"哪个模型总分第一"更有用。
读榜时还要看测试框架:模型成绩是系统成绩的一部分
基准测试里的 Agent 不是一颗裸模型。Harness(智能体运行框架)会提供系统提示、工具定义、上下文压缩、调用循环和结束条件;同一个模型换一套框架,执行路径和结果都可能改变。
DeepSeek 的官方说明明确标注:1017 在 Terminal-Bench 4.0 使用 Claude Code 框架,在 DeepSWE v1.1 使用 Mini-SWE-V2 框架;技术报告还把 Agents' Last Exam、Automation-Bench 标为使用各自的官方框架。也就是说,榜单结果描述的是模型与测试框架共同组成的系统表现。要进一步复现或和其他榜单比较,还得检查任务版本、Harness 版本、工具权限、运行预算和评分口径是否一致。
还有一个容易忽略的时间问题:DeepSWE 的公开榜单标注更新时间为 2026 年 9 月 22 日,早于 1017 的 10 月 17 日发布;其公开榜单当时的运行设置也不等同于模型卡里列出的 Mini-SWE-V2 测试。把两个页面的分数直接拼成同一张最新排行榜,会造成不公平比较。本文的数值因此只作为 DeepSeek 模型卡公布的对照结果呈现,并明确标注来源。
独立长程任务研究提醒我们:跑完一条轨迹,不等于完成了工作
另一项更接近"长时间持续做事"的研究是 Long-Horizon-Terminal-Bench。它收录 46 项、覆盖 9 类任务,把研究复现、软件工程、科学计算等流程拆成带中间检查点的子任务;一次运行平均约 231 个 Agent 回合、85 分钟。论文报告中,表现最好的测试配置在达到 95% 部分得分阈值时,成功率为 15.2%;要求满分时为 10.9%。这不是对 1017 的测试,也不能和 DeepSeek 模型卡上的分数直接比较,但它说明:把"做了一部分"与"完整交付"分开评分后,长流程的难度会显露出来。
网页任务也有相似现象。Odysseys用 200 个跨网站浏览任务测试 Agent,并将每项工作拆成可验证的检查点;该基准报告中,最佳模型的完整任务成功率为 44.5%。这提醒我们,步骤多、页面多、信息分散时,Agent 可能已经完成了大部分工作,却仍在关键检查点上失手。
这两项研究和 1017 的厂商分数回答的是不同问题。前者展示长流程任务普遍存在的完成与验收难点;后者提供 1017 在特定基准与设置下的成绩。把两者放在一起看,能看到进展,也能避免把某一组高分误读成"长程任务已经解决"。
从"能跑很久"到"交付可靠",还差哪几步
一项长程任务能否完成,至少要同时满足四个条件:
目标能拆成可检查的小步骤。 只说"把项目做好"很难判断进度;说清楚要改哪些功能、产生哪些文件、通过哪些测试,Agent 才有阶段目标。
中间状态能被延续。 Agent 要记住已经确认的事实、失败过的尝试、尚未解决的问题。否则每次压缩上下文或切换阶段,都可能把前面工作丢掉。
反馈能改变下一步。 命令执行成功只代表命令返回了结果。Agent 还得判断结果说明什么;若连续重复相同操作却没有新证据,就应停下来诊断,而非继续消耗预算。
完成要由产物验证。 "我已经完成"是模型的陈述,不是验收。要运行测试、检查文件、确认结果符合需求,并把未验证的部分说清楚。
这几项也是普通使用者可以直接借鉴的。给 Agent 一项复杂任务时,可以要求它每个阶段都留下四项记录:目标、动作、实际结果、下一步依据;提前约定验收方式和停滞条件;最后要求它提供产物路径、验证命令及实际结果。这样的要求不会让模型突然变得可靠,却能让它的进度更容易检查,也更容易在失控前接手。
1017 能说明什么,又不能说明什么
目前比较稳妥的结论是:DeepSeek V4.1 Flash 1017 在官方公布的多项编码和 Agent 基准上较上一版本提升,在部分任务上超过了表内对照模型;它值得纳入长程任务能力的比较。但当前公开证据还不足以说明它已经能普遍、稳定地独立完成复杂工作。
原因不只是模型分数还不够高。不同任务的失败方式不同,框架会影响表现,公开演示也不等于可重复的对照实验。尤其 1017 更新说明没有披露完整的训练细节和所有测试配置,读者应把"官方公布的基准成绩""论文中的技术设计"和"演示项目"分开理解。
所以,看到 Agent 连续工作很久时,不妨追问三个具体问题:它每一步拿到了什么新证据?这些证据怎样改变了计划?最终产物经过什么检查?长程任务真正考验的,不是它能不能一直做,而是能不能在一连串变化中持续推进,并用可验证的结果结束任务。
主楼- 暂无回复